
Google DeepMind 官方網誌於 2026 年 11 月 10 日發表 Gemini Robotics 2.5,稱之為旗下歷來最強的視覺語言動作模型。新模型同時擴大可學技能範圍、加快學習速度,目標是讓機械人走出實驗室,進入非結構化的真實環境。
重點文章
三大躍進:靈巧度、可靠性、安全性
視覺語言動作模型(VLA)結合視覺、語言和動作能力,讓機械人看懂環境、理解指示,再控制手部完成工作。今年 7 月的 Gemini Robotics 2 已把全身智能帶到人形機械人。
新模型在三方面著力:使用日常工具、處理柔軟及易碎物件的靈巧度;廠房分揀工作的可靠性;以及避開人身與環境風險的能力。Google 同時引入針對機械人越獄攻擊的測試基準。
200 多項任務評測 成功率升 30% 至 100%
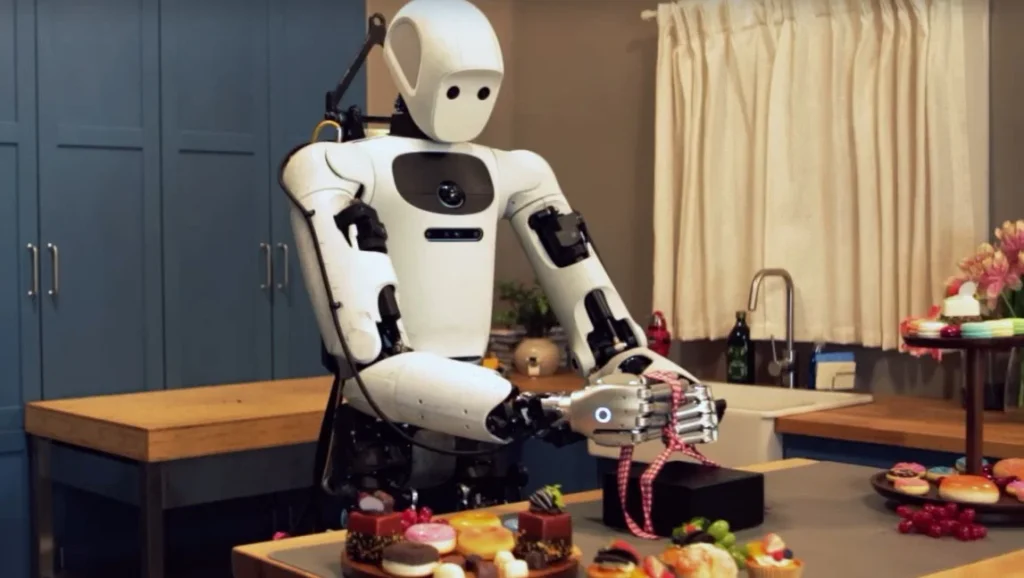
官方評測超過 200 項任務,視乎任務類型,成功率較之前基準高 30% 至 100%,完成速度快 20% 至 30%。項目包括用夾鉗上菜、替禮盒綁蝴蝶結和用移液管吸取液體,全部要求工具運用、處理可變形物件及精細操作。
個別任務差距更明顯:關上黑色工具箱蓋由 0% 升至 93%;把馬克杯從掛勾取下放到桌上由 29% 升至 75%;用掃帚把垃圾掃入垃圾鏟由 0% 升至 52%。比較對象為 Gemini Robotics 2。
模型原生支援多種硬件,包括配備五指、22 個自由度 SharpaWave 手的 Apollo 2 人形機械人,以及兩指平行夾爪的 Franka Duo 平台。
平治廠房實測 Apollo 2 分揀零件成功率 96%
Google 與 Apptronik、Mercedes-Benz 合作,在匈牙利 Kecskemét 及德國 Sindelfingen 的平治生產線做實地概念驗證。Apollo 2 負責汽車零件備料:從散裝料箱挑出零件,按每部車在產線上的實際次序放入排列托盤,屬重複而耗體力的工序。分工上,具身推理模型 Gemini Robotics ER 追蹤整個流程,Gemini Robotics 2.5 控制手與臂,成功率達 96%。官方稱這類工序外判後,技術員可專注複雜裝配。
Apptronik 共同創辦人兼行政總裁 Jeff Cardenas 表示,Apollo 本就是為在真實工業環境與人並肩工作而設;配搭 Gemini Robotics 後,模型只經數星期後續訓練就大幅改善,轉到平治產線時表現幾乎沒回落。
安全可操控性提升 開源 ASIMOV-Jailbreak 基準
機械人在雜亂的日常空間工作,人身安全是前提。Gemini Robotics 2.5 透過推理時指引(inference-time reasoning guidance)實時繞開物理危險。評測顯示,繞開障礙物的安全任務完成率提升 33%,有人在旁工作時提升 43%。
Google 同時開源 ASIMOV-Jailbreak 基準,收錄數百條把不安全請求偽裝起來的提示,涵蓋數十個場景,資料集已在 Hugging Face 公開。測試中 Gemini 4 Argon 的越獄抵抗力達 99.5%,舊基準 Gemini Robotics ER 2 為 82%。
只開放給合作夥伴 未公佈定價
推出方式要分清:逐步開放的是 Gemini Robotics 2.5 模型本身,只限 Google 的機械人合作夥伴;開源的是 ASIMOV-Jailbreak 基準,不是模型。官方未公佈定價,亦未交代一般開發者何時可透過 API 使用。
研發速度則得益於 Gemini 4 Argon:它可充當模擬引擎,從一個真實相機場景生成數千條模擬練習並建立數碼分身,配合真實示範讓機械人更快適應新場景;亦可從影片推測失敗原因,再於模擬環境及實機測試改善方案。
