
約兩週前,Google 宣佈推出 Gemini 4 Carbon,一度被視為再次在 AI 模型領域取得領先地位。然而,由於發佈過程稍顯緩慢,該模型現在已略顯過時。Anthropic 剛推出其頂尖模型 Fable 5.2,即使在較低推理強度下,也在 Artificial Analysis 測試中超越新的 Gemini 模型。儘管目前模型週期循環速度極快,但經過為期兩週針對選定安全專家的測試階段後,Carbon 現已正式全面推出。
重點文章
Carbon 定位與成本分析
Google 表示,Carbon 並非取代先前推出的 Gemini 4 Argon,而是作為互補產品。根據 Google 說法,Argon 仍是大多數軟體工程及知識工作任務的最佳選擇,而 Carbon 則專為突破模型智能極限的任務而設計。這有點令人意外,因為兩個模型的 Token 價格相同,但 Carbon 在基準測試中得分更高。
Google 列舉了複雜的多步驟編碼、除錯以及開放式科學研究作為 Carbon 的優勢。然而,在處理複雜除錯或開放式研究時,Carbon 會使用比 Argon 更多的 Token 以進行更深層次的推理並執行更長的驗證迴圈。因此,儘管單個 Token 的價格相同,總帳單很可能比使用 Argon 時更高。
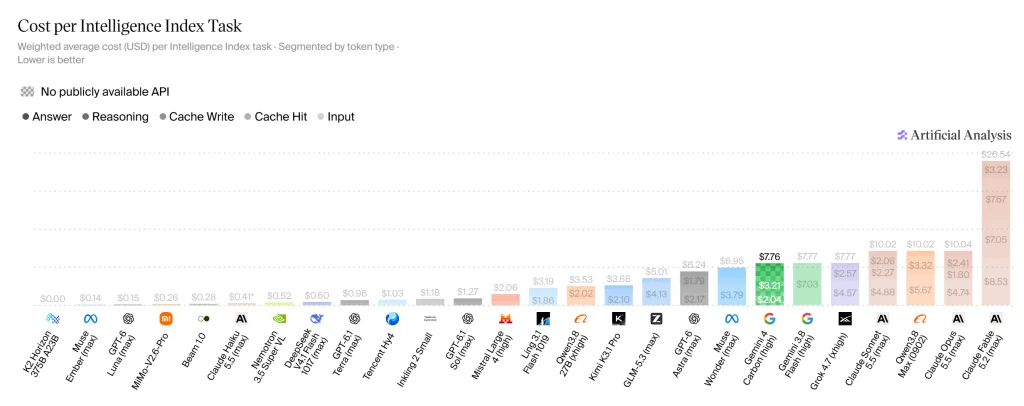
在兩週前公佈的 Artificial Analysis 測試中,Carbon 每個解決任務的成本為 7.76 美元,這是按每百萬輸入 Token 4 美元和每百萬輸出 Token 20 美元的標準定價計算。這使得 Carbon 比舊款經濟型模型 Flash 3.8 更便宜,同時提供更佳的效能,這絕非易事。預計 Gemini 4 的 Flash 變體將很快推出。
在同一測試中,Opus 5.5 Max 的成本為 10.04 美元,GPT-6 Astra Max 為 6.25 美元。Fable 5.2 在最高級別時每個任務高達 26.50 美元;而在 High 級別時,雖然「僅」需約 9 美元,但其總指數仍領先 Carbon 兩個點(62 對 60)。
付費級別的開發人員和企業客戶可透過 Google AI Studio 中的 Gemini API、Android Studio 或 Gemini for Business 存取該模型。 introductory 價格維持在每百萬輸入 Token 2 美元和每百萬輸出 Token 10 美元。
代理群集功能預覽
隨著模型推出,Google 在 Google Antigravity 中預覽了「/swarm」功能,這是 Claude Code 的對應產品。此新功能將單一提示轉化為協同工作的代理團隊,其進度可即時追蹤。Carbon 負責需要深度推理的角色,如架構設計、協調和審計,而更快、更輕量的模型則在平行隔離的工作空間及作為對抗性驗證者運行。
Google 展示了一些例子,包括用戶以騎著 GBike 的鵜鶘身份探索 Mountain View 的 Google 園區的 3D 遊戲、基於歷史照片重建艾菲爾鐵塔建設過程的互動式 3D 項目,以及具有座位特定空間聲學的 18 世紀古鋼琴可玩版本。
業界正就這類代理群集的效益比展開辯論。OpenAI 和 Anthropic 近期態度謹慎,研究者亦持懷疑態度。主要好處似乎是透過並行化提升速度,但這過程相當複雜。
部分基準測試領先與成本優勢
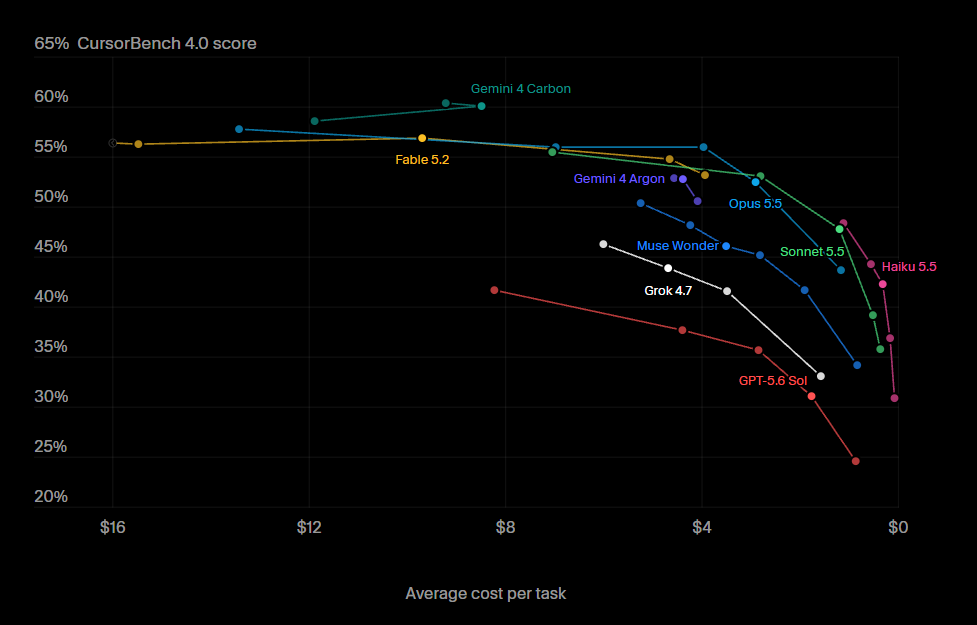
除了 10 月底已知的效能數據外,Google 引用了新的基準結果。Carbon 在編碼基準 CursorBench 4.0 上排名第一,領先於 Fable 5.2;在 Perplexity 的 WANDR 和 Zapier 的 AutomationBench 上也表現優異,其每個任務的成本不到次佳模型 Fable 5.2 的一半。
為了分析包含圖表、藍圖和表格的密集文件,Google 與 Artificial Analysis 合作推出了新的多模態知識代理(MKA)基準。Carbon 在此排名第二,緊隨 Fable 5.2 之後,略勝 Opus 5.5,但平均成本不到第一名模型的六分之一。
網路防禦與零日漏洞發現能力
透過 Fairwind 計劃進行為期兩週的早期存取測試階段,Google 首次分享具體的網路防禦實際成果。作為安全公司 Wiz 的 Scan for Good 計劃的一部分,Carbon 在掃描兩家大型 SaaS 供應商時,於兩小時內發現了真實的零日漏洞。Google 自家的雲端安全團隊也利用該模型為一個熱門開源專案中的兩個已知錯誤寫出可行的概念驗證攻擊程式。
只有在證明這些錯誤可被關鍵性地利用後,才能確認其嚴重性,這可比擬 PHP2Shell 漏洞。在 Google 的自主安全系統 Project Fortify 中,Carbon 使開源代碼庫的檢測率比 Argon 提高了超過 25%。
Google 強調網路安全能力是 Carbon 的一個特別強大的特點。據 Google 稱,該模型在 SEC-bench Pro(尋找漏洞)、ExploitGym(利用漏洞)和 CWE-bench v1(修補漏洞)等基準測試中領先,但這僅適用於透過 Fairwind 計劃提供的版本。Google 未提供具體數字。
安全性報告與抗注入測試表現
Google 還發佈了完整的安全報告和模型卡。在一項涉及 375 個任務的內部誠實度測試中,Carbon 通過了 92% 的測試(Argon 為 70%),並在 98% 的案例中拒絕捏造缺失的實驗數據。
在模擬網路攻擊中,該模型阻擋了 99% 來自自適應紅隊代理的攻擊路徑,並將每次嘗試的突破率從 Argon 的 3.1% 降至 0.8%。來自 Trajectory Labs 的外部測試者在 132 小時內進行了超過 13,000 次查詢,未能找到任何通用的越獄方法。
