
重點文章
Argon 推出兩星期後再出新模型
Google 於 10 月 28 日公佈新一代前沿模型 Gemini 4 Carbon,距離上一款 Gemini 4 Argon 推出僅兩星期。Google DeepMind 高級副總裁兼 Google 首席 AI 架構師 Koray Kavukcuoglu 表示,Carbon 是 Google 目前最強的模型,主打頂尖的資訊安全能力及長時間任務處理能力。不過與 Argon 一樣,Carbon 暫時未向一般用戶開放。
Artificial Analysis 智能指數排名第一
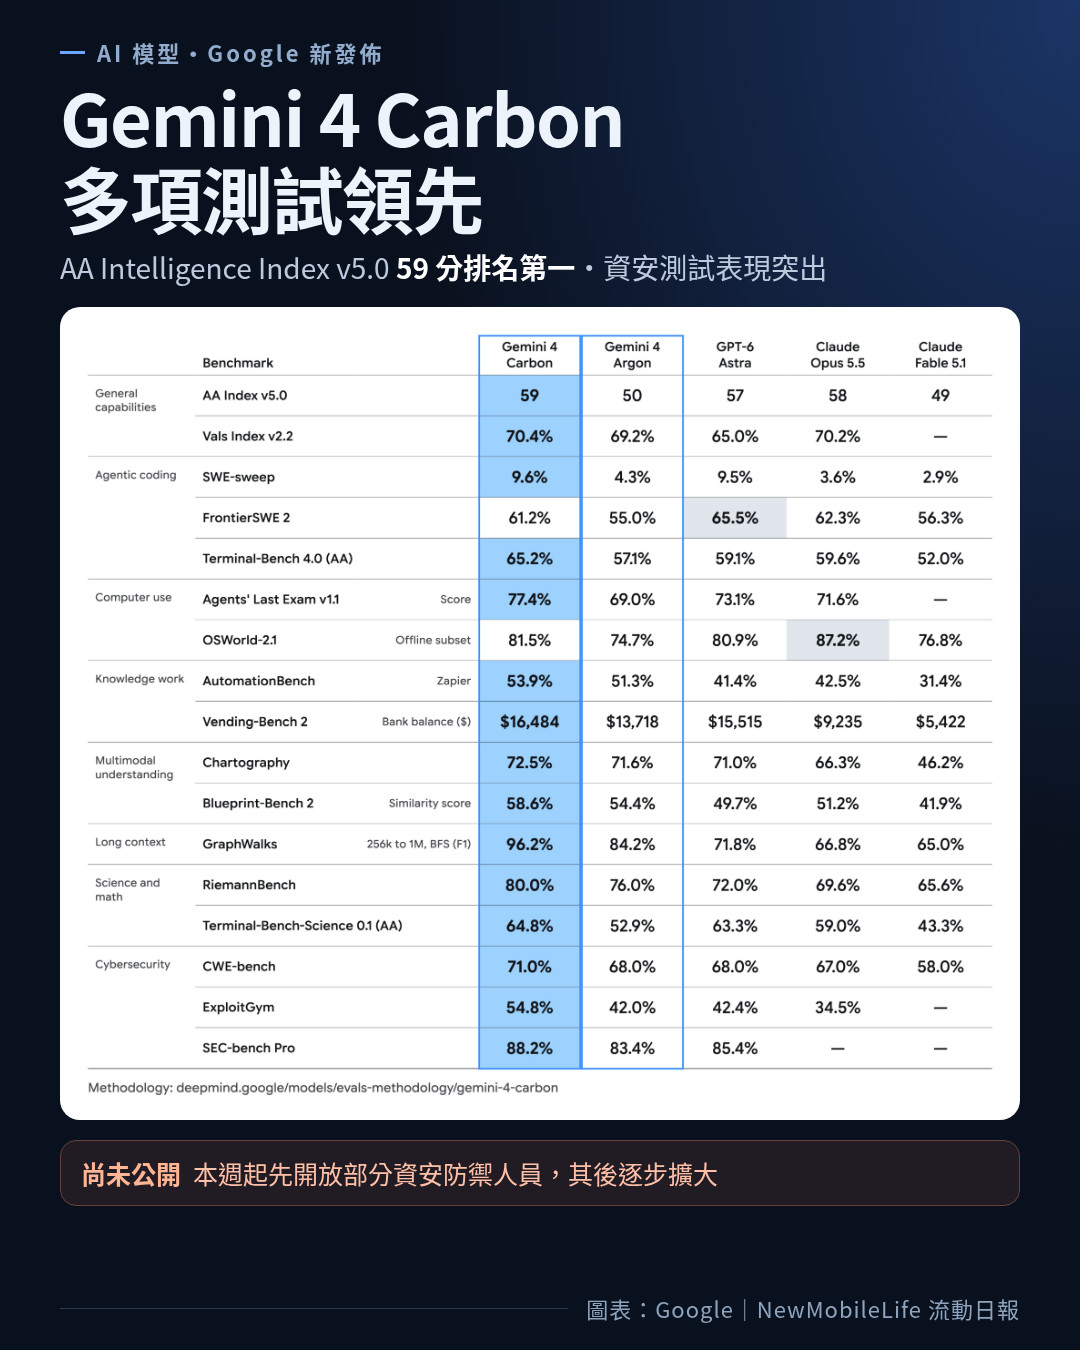
Google 指出,Carbon 在最新更新的 Artificial Analysis Intelligence Index v5.0 取得 59 分,排名第一,比 Argon 的 50 分高 9 分。Carbon 在編程及代理任務方面亦有明顯進步;在網頁開發方面,Carbon 於 WebDev Arena 的 Elo 分數上升 89 分至 1768,排名第四。
資安測試成績領先
資訊安全是 Carbon 的主要賣點。Google 表示,Carbon 在漏洞偵測、驗證及修補整個資安防禦流程均達到業界頂尖水平:在尋找真實軟件漏洞的 SEC-bench Pro 取得 88.2%,在漏洞利用測試 ExploitGym 取得 54.8%,在針對根本原因修補漏洞的 CWE-bench 則取得 71.0%。
Google 又指,在內部測試中,Carbon 生成安全程式碼的成功率是 Argon 的兩倍以上;Chrome 團隊亦表示,Carbon 生成高質素修補程式的表現比另一間 AI 公司的大型前沿模型好十倍以上。
主要基準測試比較
| 測試項目 | Gemini 4 Carbon | Gemini 4 Argon | GPT-6 Astra | Claude Opus 5.5 |
| AA Intelligence Index v5.0 | 59 | 50 | 57 | 58 |
| SEC-bench Pro(尋找漏洞) | 88.2% | 83.4% | 85.4% | — |
| ExploitGym(漏洞利用) | 54.8% | 42.0% | 42.4% | 34.5% |
| CWE-bench(修補漏洞) | 71.0% | 68.0% | 68.0% | 67.0% |
| FrontierSWE 2 | 61.2% | 55.0% | 65.5% | 62.3% |
| OSWorld-2.1 | 81.5% | 74.7% | 80.9% | 87.2% |
| Terminal-Bench 4.0 | 65.2% | 57.1% | 59.1% | 59.6% |
可連續運行數天處理長時間任務
Carbon 針對難度更高的長時間工程問題而設計,適合需要持續運作的代理工作流程。Google 表示,內部團隊曾看到 Carbon 連續運行數天,在遇到死衚衕後仍堅持處理複雜的多步驟工程任務,例如在大型程式碼庫及底層系統中找出細微錯誤的根本原因並作出修補。
並非每項測試都第一
雖然 Carbon 在大部分測試中領先,但並非每項都排第一。根據 Google 公佈的比較表,OpenAI 的 GPT-6 Astra 在 FrontierSWE 2 取得 65.5%,高於 Carbon 的 61.2%;Anthropic 的 Claude Opus 5.5 則在 OSWorld-2.1 以 87.2% 領先 Carbon 的 81.5%。Artificial Analysis 的 Coding Agent Index 中,Claude Opus 5.5 同樣排名第一,Carbon 位列第二。Ars Technica 亦指出,各前沿模型的分數其實相當接近,差距只有數分。
API 首發價與 Argon 相同
價格方面,Gemini 4 Carbon 推出時會採用與 Argon 相同的首發優惠價,每 100 萬個輸入 token 為 2 美元、每 100 萬個輸出 token 為 10 美元,快取輸入 token 則按輸入價格減 95%。優惠期結束後,價格會調整為每 100 萬個輸入 token 4 美元、輸出 token 20 美元,即首發價為半價。Google 未有公佈優惠期何時結束。
暫未公開 先開放給資安防禦人員
Google 表示會以審慎方式推出 Carbon,並參與美國政府的自願性模型發佈前測試程序。由本週起,Carbon 只會開放給部分資安防禦人員,之後再透過 Google 的 Fairwind 計劃逐步擴展至更多受信任夥伴。Google 會繼續收集意見及改善防護措施,然後「盡快」透過旗下產品向開發者、企業及消費者推出,但未有公佈確實日期。
資料來源:Google
