
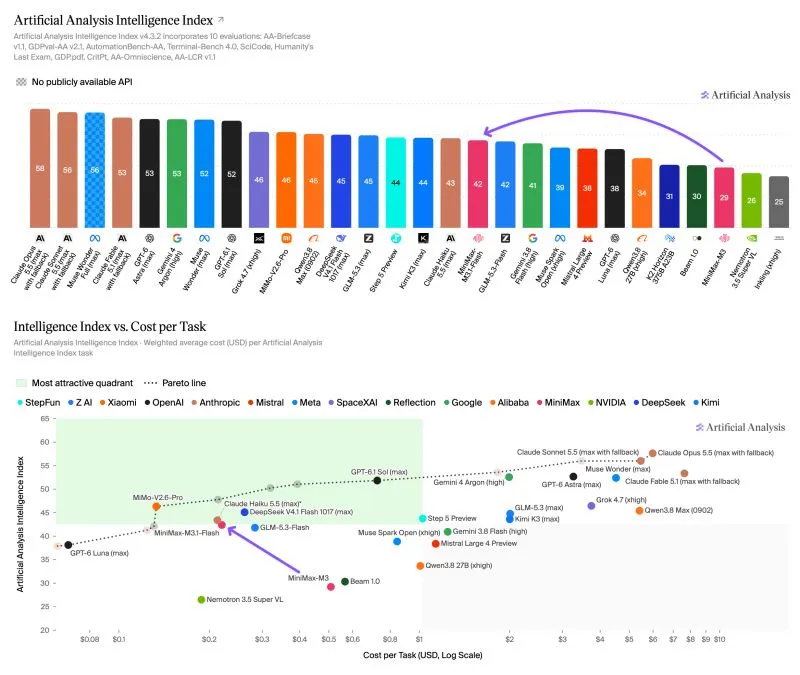
MiniMax 推出推理模型 M3.1 Flash,在 Artificial Analysis 的 Intelligence Index 取得 42 分,較前代 M3 高 13 分,而每項任務成本不足前代一半。這個分數與 GLM-5.3-Flash 持平,略高於 Gemini 3.8 Flash 的 41 分,但仍落後 Deepseek V4.1 Flash 1017 的 45 分。
重點文章
複雜推理進步最大
在測試複雜推理的「Humanity’s Last Exam」中,M3.1 Flash 取得 48% 得分,同時高於 Deepseek 與 GLM。針對研究級物理推理的 CritPt 基準,該模型在 71 條複雜題目中取得 22%,高於 GLM-5.3-Flash 的 15% 及 Gemini 3.8 Flash 的 18%,僅次於 Deepseek 的 24%。事實準確度方面,M3.1 Flash 在 AA-Omniscience 測試中答對 56% 題目,明顯高於 GLM-5.3-Flash 的 28% 及 Deepseek 的 43%。
據 Artificial Analysis 指出,該模型的幻覺率達 93%,屬明顯弱點,原因是它傾向回答所有測試題目,而非在不確定時表明無法作答。
輸出 Token 較少壓低成本
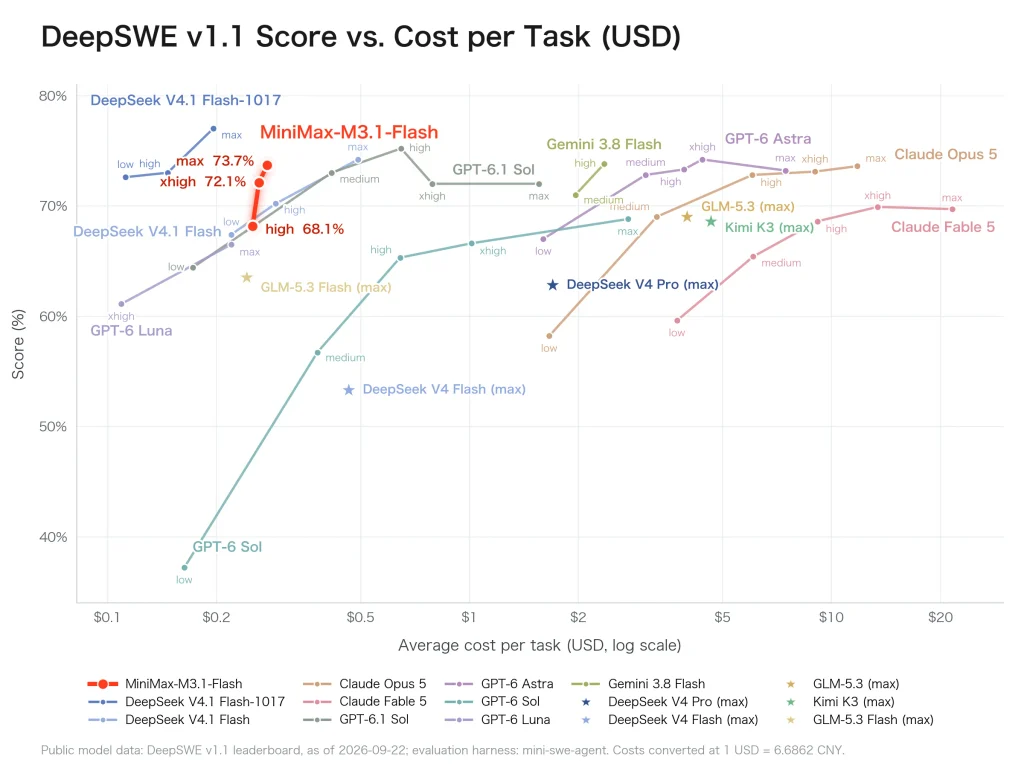
M3.1 Flash 的輸出 Token 數量遠少於競爭對手,令每項任務成本降至約 0.22 美元。MiniMax 表示,其運行速度為 M3 的三倍。在 DeepSWE v1.1 測試中,該模型得分最高達 73.7%,每項任務成本低於 0.30 美元。
百萬 Token 上下文與 API 收費
模型支援最多 100 萬個 Token 上下文,可接收文字及圖像輸入。API 定價為每百萬輸入 Token 0.15 美元、每百萬輸出 Token 0.60 美元,快取輸入為 0.015 美元。MiniMax 計劃於 10 月 23 日以開放權重形式釋出模型;API 已在 platform.minimax.io 上線,公司同時提供名為 MiniMax Code 的桌面應用程式。
與 Deepseek 各有領先
與近期推出的 Deepseek V4.1 Flash 1017 直接比較,兩款模型並非全面分出高下。Deepseek 在 Intelligence Index 以 45 分領先 MiniMax 的 42 分,在 CritPt 基準亦以 24% 稍勝 MiniMax 的 22%。
MiniMax 在其他測試中領先:「Humanity’s Last Exam」取得 48%,Deepseek 為 43%;AA-Omniscience 事實準確度為 56%,Deepseek 為 43%。由於整個基準測試所需的輸出 Token 較少,MiniMax 每項任務成本為 0.22 美元,低於 Deepseek 的 0.26 美元;兩者輸出 Token 分別約為 1.89 億個及 2.24 億個。兩款模型均將推出開放權重版本,Deepseek 已在 Hugging Face 上架,MiniMax 則於 10 月 23 日跟隨。
